Этот материал — для тех, кто уже понял проблему и хочет решить её руками. Если AI-краулер не может получить полезный HTML, не понимает, кому принадлежит сайт, или видит противоречивые данные, хороший текст сам по себе не станет источником для ChatGPT или Perplexity. Ниже — технический минимум, который я использую при подготовке сайтов к GEO и AEO.
Важно: открытый доступ не гарантирует цитирование. Он лишь убирает фундаментальный барьер. После настройки всё равно нужны точные ответы, авторство, доказательства опыта и нормальная поисковая индексация.
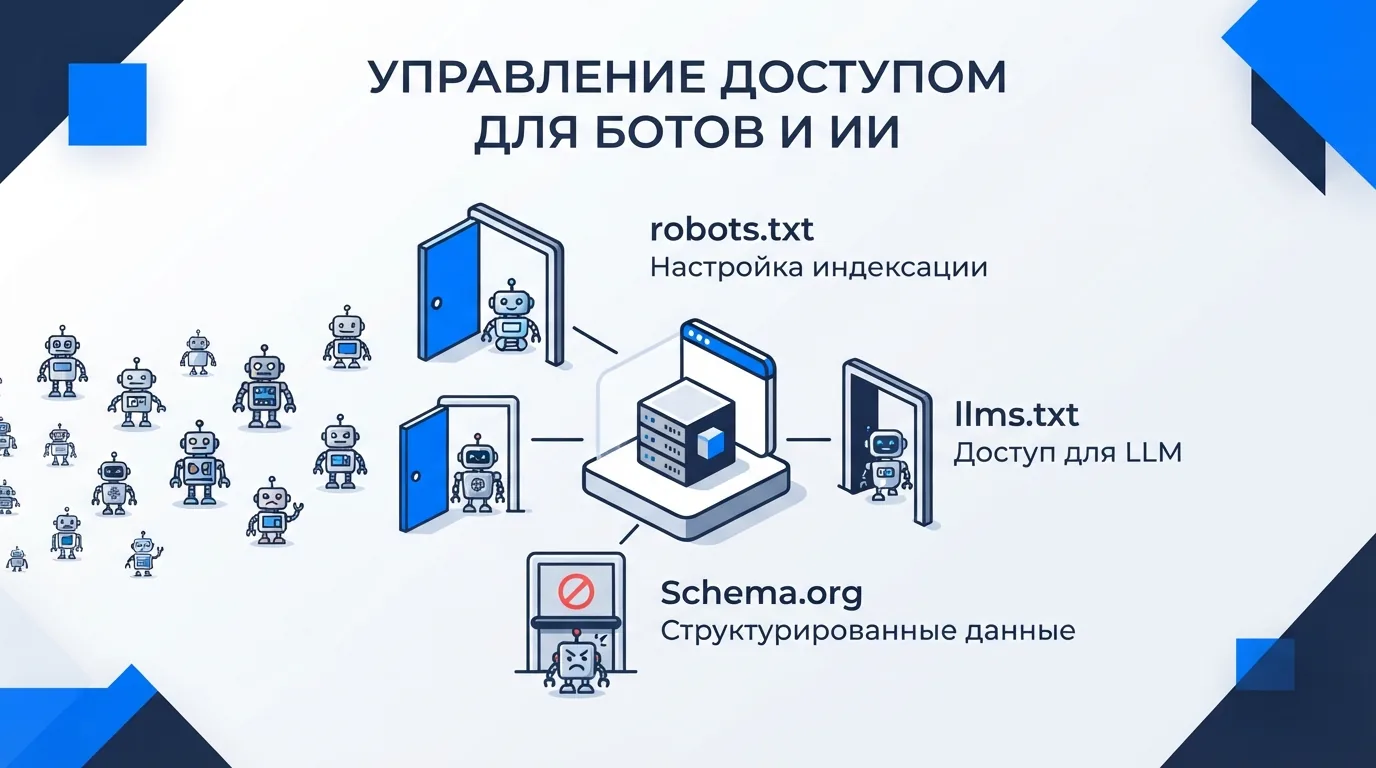
Открываем доступ AI-краулерам в robots.txt
robots.txt — это не список «разрешений для нейросетей», а правила обхода. Я начинаю с инвентаризации: какие публичные разделы должны быть доступны, а какие обязаны остаться закрытыми. Личный кабинет, корзина, служебный поиск, staging, параметры фильтров и страницы с персональными данными нельзя открывать ради AI.
Для публичного корпоративного сайта базовый шаблон может выглядеть так:
User-agent: GPTBot
Allow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: ChatGPT-User
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Google-Extended
Allow: /
User-agent: CCBot
Allow: /
User-agent: Bytespider
Allow: /
User-agent: Meta-ExternalAgent
Allow: /
User-agent: *
Disallow: /admin/
Disallow: /account/
Disallow: /cart/
Disallow: /search/
Sitemap: https://example.ru/sitemap.xml
Не копируйте этот файл вслепую: если проект работает в регулируемой тематике или содержит закрытые разделы, правила нужно согласовать с безопасностью и юристами. Кроме того, robots.txt — добровольный протокол; он не заменяет аутентификацию, noindex и контроль доступа на сервере.
Зачем нужны эти user-agent
GPTBotотносится к краулингу OpenAI; его правила отделены от поискового бота.OAI-SearchBotнужен для поиска ChatGPT: это ключевой агент, если вы хотите быть доступными для актуальных ответов с веб-поиском.ChatGPT-Userобозначает запрос страницы по действию пользователя. Не путайте его с массовым обходом.ClaudeBot— робот Anthropic; отдельно отслеживайте фактические запросы и официальную документацию компании.PerplexityBot— робот Perplexity для веб-доступа.Google-Extendedуправляет отдельными сценариями того, как Google берёт контент в AI, но Googlebot не заменяет и обычную индексацию не определяет.CCBot— робот Common Crawl; его открытие зависит от вашей политики работы с открытыми веб-данными.BytespiderиMeta-ExternalAgentотносятся к экосистемам ByteDance и Meta. Их не обязательно разрешать всем проектам, но полезно принимать осознанное решение, а не оставлять случайный запрет.
После правки смотрю не на один только файл. CDN или WAF может вернуть роботу 403, JavaScript-челлендж или CAPTCHA, хотя robots.txt разрешает обход. Посмотрите access-логи с нужным User-Agent и обязательно проверяйте важные URL: главную, услуги, статьи и кейсы.
Создаём llms.txt
llms.txt — компактная машиночитаемая карта сайта. Он не заменяет sitemap, официальным фактором Google не считается и «приоритетной» для любой LLM страницу не делает. Его задача проще: дать агенту короткую навигацию по самым полезным и достоверным URL.
Ниже — технический минимум, который я использую при подготовке сайтов к GEO и AEO
На Nasloy можно посмотреть живой пример llms.txt. Хороший файл начинается с понятного названия и краткого описания, а затем группирует ссылки по смыслу.
# Название компании
> Одно предложение: что делает компания и для кого.
Не превращайте файл в полную выгрузку sitemap. Достаточно 15–50 ключевых URL: коммерческие страницы, лучшие гайды, кейсы, контакты, политика и важные документы. Не добавляйте ссылки на параметры, архивы, черновики и материалы под NDA. После публикации проверьте ответ 200 OK, тип text/plain или text/markdown, отсутствие редиректа на HTML и корректность абсолютных URL.
Микроразметка Schema.org, которая помогает понять факты
Schema.org — не кнопка «цитировать сайт». Она формализует то, что уже видит посетитель: кто автор, какая организация стоит за страницей, какую услугу она предлагает и где находится вопрос с ответом. Неверная разметка опаснее отсутствующей: не указывайте вымышленные рейтинги, цены, сотрудников или FAQ, которого нет на странице.
Organization
Разметка организации нужна на главной, контактах и страницах компании. Свяжите название, URL, логотип, контакты и только подтверждённые официальные профили.
{
 "@context": "https://schema.org",
 "@type": "Organization",
 "name": "Пример компании",
 "url": "https://example.ru/",
 "logo": "https://example.ru/logo.png",
 "email": "hello@example.ru",
 "sameAs": ["https://t.me/example"]
}
Article и автор
Для каждой статьи нужны headline, datePublished, dateModified, изображение, канонический URL и автор. Дата должна совпадать с тем, что видит пользователь. Если автор — специалист, добавьте реальную страницу профиля.
{
 "@context": "https://schema.org",
 "@type": "Article",
 "headline": "Как настроить сайт для AI-краулеров",
 "datePublished": "2026-08-20",
 "dateModified": "2026-08-20",
 "author": {"@type": "Person", "name": "Автор", "url": "https://example.ru/about/"},
 "mainEntityOfPage": "https://example.ru/blog/ai-crawlers/"
}
Service и FAQPage
Service полезен для страниц услуг, где видны название, описание, территория работы и способ связи. FAQPage используйте только для настоящих вопросов и ответов. В JSON-LD нет места для скрытых ключевых слов: текст ответа обязан существовать на странице.
{
 "@context": "https://schema.org",
 "@type": "FAQPage",
 "mainEntity": [{
 "@type": "Question",
 "name": "Нужен ли llms.txt каждому сайту?",
 "acceptedAnswer": {"@type": "Answer", "text": "Нет. Сначала обеспечьте доступность HTML, индексацию и полезный контент."}
 }]
}
Проверяю разметку валидатором Schema.org и затем сверяю её вручную с экраном страницы. Валидный JSON не означает достоверный JSON.
Если сайт на React, Vue или SPA — главная ловушка
У SPA есть неприятный разрыв между тем, что видит пользователь, и тем, что получает простой HTTP-краулер. Браузер скачивает оболочку, выполняет JavaScript и рисует приложение. Робот, который JS не исполняет, может получить <div id="root"></div> и ни одного полезного слова.
На nasloy.ru я встретил именно это: исходный HTML ключевых маршрутов содержал 0 символов основного текста. Внутренний GEO/AEO-проверяющий инструмент зафиксировал проблему; стартовый AEO-балл был 36. После внедрения статических семантических снимков и переработки контента показатель вырос до 81. Цифра — диагностическая метрика инструмента, а не обещание позиции в поиске.
Технически проект использует createRoot(), а не hydrateRoot(). Для этой задачи это не недостаток. hydrateRoot() нужен, когда клиент должен «подхватить» HTML, созданный полноценным SSR, сохранив его DOM и состояние. В моём случае сборочный скрипт создаёт статический снимок для каждого SEO-маршрута и помещает в #root H1, лид, H2, списки и FAQ из тех же данных, что использует интерфейс. Затем браузерный createRoot().render() заменяет временный снимок полноценным React-интерфейсом.
Упрощённая логика выглядит так:
const template = await readFile('dist/index.html', 'utf8');
const snapshot = `<h2>${escape(title)}</h2><p>${escape(lead)}
const html = template.replace('<div id="root"></div>', `<div id="root">${snapshot}</div>`);
await writeFile('dist/services/example/index.html', html);
Ключевой принцип — один источник данных. Снимок нельзя писать вручную отдельно от React-компонента: иначе текст для робота и человека разойдётся, а поддержка станет бесконечной. На Nasloy модуль данных собирается build-скриптом, а на выходе создаются отдельные HTML-энтрипойнты с собственными title, description и canonical.
Это компромисс, а не универсальная архитектура. Для личных кабинетов, сложной персонализации или большого каталога лучше выбрать SSR/SSG-фреймворк: Next.js, Nuxt, Astro либо серверный рендер текущего стека. Но для уже работающего SPA семантические snapshots — безопасный этап миграции: они дают сырому HTML содержание без немедленной переписи всего продукта.
Проверка результата
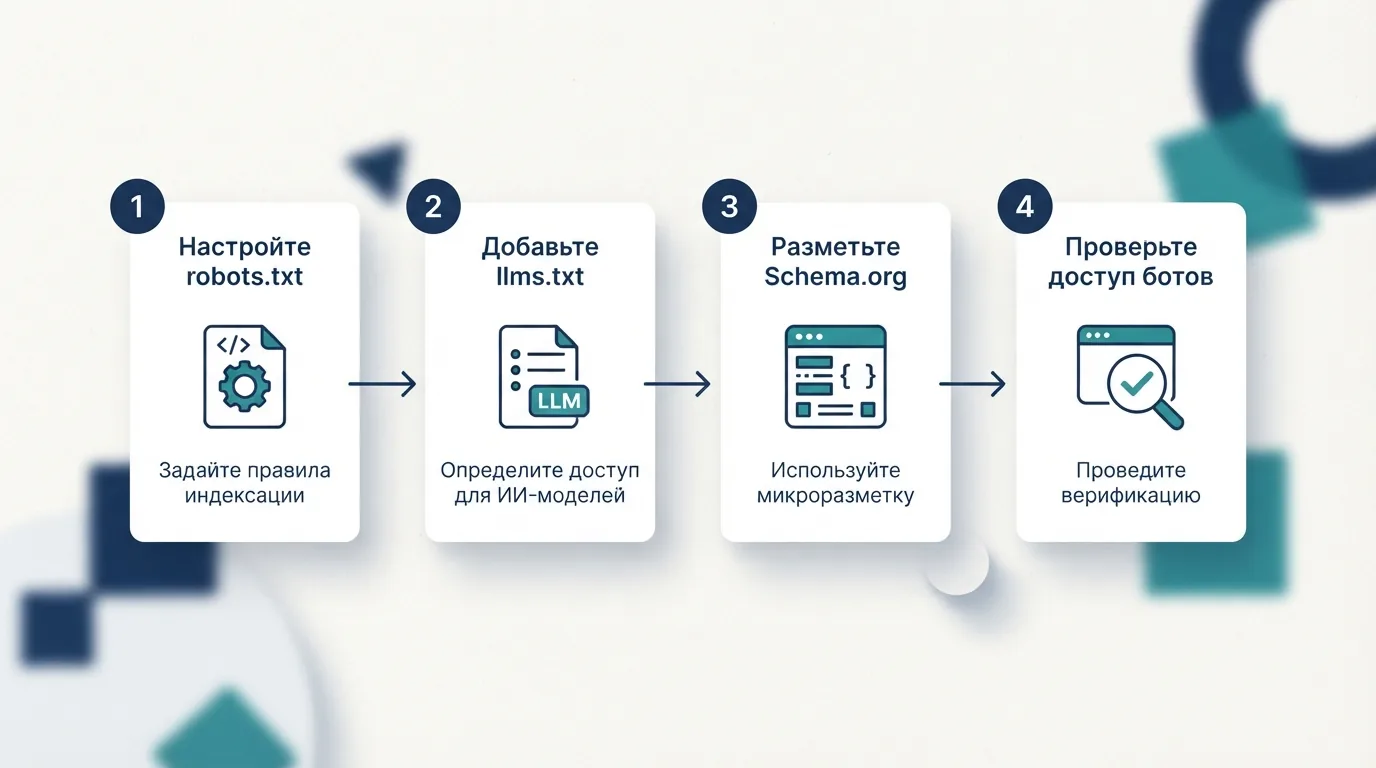
После релиза не ограничивайтесь тем, что «страница открылась в браузере».
1. Откройте исходный код или получите HTML через curl и найдите H1 и первые абзацы.
2. Убедитесь, что robots.txt, llms.txt, sitemap и канонические URL отдают 200.
3. Проверьте noindex, заголовки X-Robots-Tag, 301-цепочки и ответ WAF.
4. Провалидируйте JSON-LD и сравните его с видимым текстом.
5. Запустите GEO/AEO-аудит: он проверит сырой HTML, правила для роботов, llms.txt, метатеги, canonical и базовые AEO-сигналы.
Если нужно обсудить проект, а не просто получить автоматический балл, свяжитесь с Nasloy Lab. Я посмотрю, где находится настоящий узкий момент: доступ роботов, рендеринг, структура ответа или доверие к бренду.
Если нужно сделать системно
Техническая настройка — первый слой. Чтобы сайт чаще становился источником, её нужно связать с приоритетными страницами услуг, экспертным контентом, кейсами, сущностями бренда и измерением контрольных запросов. Это входит в работу по GEO-продвижению и AI SEO.
Перед внедрением также рекомендую пройти чек-лист 20 признаков невидимости сайта для ChatGPT и Perplexity: он помогает не пропустить соседние проблемы, которые не исправляются одним robots.txt.
Связанные направления Nasloy Lab
- GEO и продвижение в нейросетях — системная работа с доступностью, контентом и цитируемостью.
- SEO-продвижение — поисковый фундамент для органического спроса.
- Web-разработка — исправление рендеринга, скорости и технической архитектуры сайта.
Официальные источники
OpenAI: управление ботами и ChatGPT Search