Как я собираю sitemap.xml и не забываю ни одной страницы
Sitemap — это карта для краулера. Показываю, какие страницы попадают в мой sitemap, какие нет и как собрать файл за минуту.
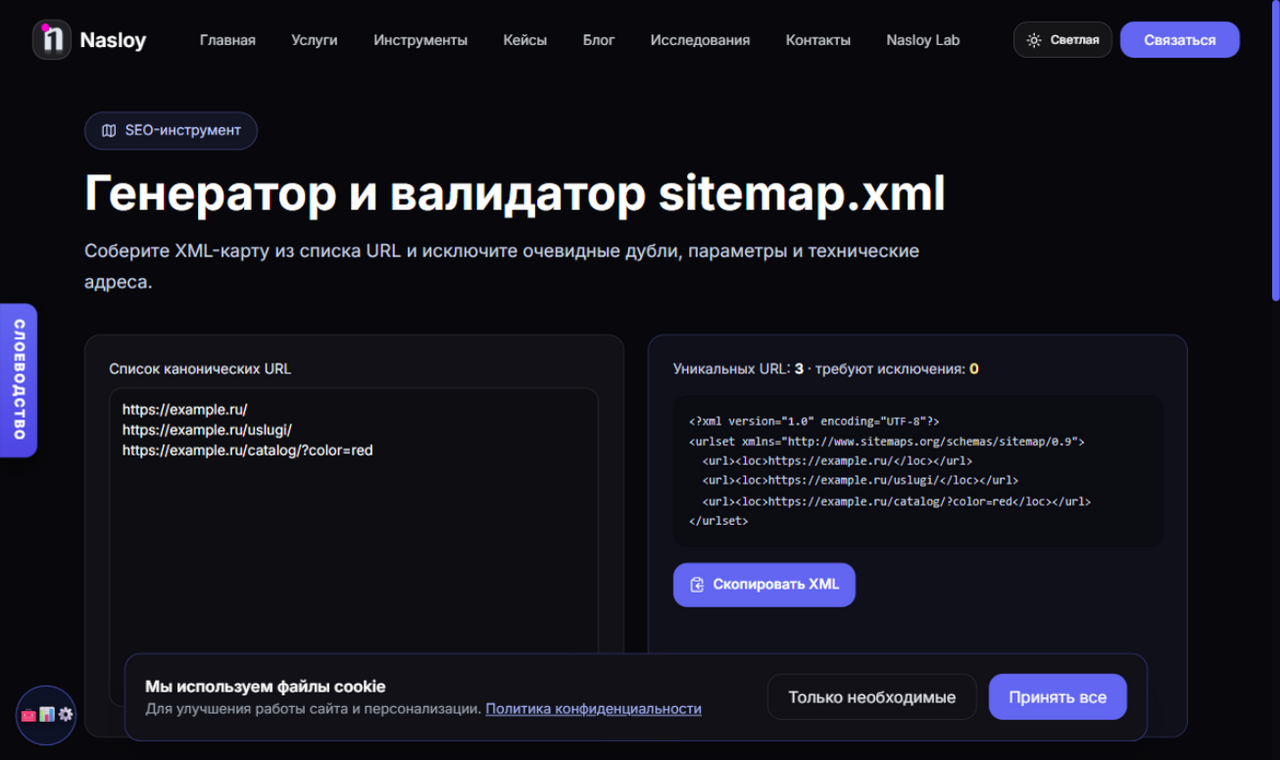
Sitemap — это не формальность, а навигатор для краулера: что сканировать, где искать и когда обновлять. Собранный наугад sitemap работает как карта, нарисованная по памяти, — вроде есть, а заблудиться проще.
Что попадает в мой sitemap
- Все индексируемые страницы с уникальным контентом: главная, категории, товары, статьи.
- Только canonical-адреса: никаких дублей и версий с параметрами.
- Актуальный lastmod — дата реального изменения, а не сегодняшняя дата «для вида».
Что я исключаю всегда
Страницы с noindex, служебные адреса, результаты внутреннего поиска, фильтры без спроса и всё, что отвечает 404 или редиректом. Каждая мусорная строка в карте — это приглашение сканировать пустоту.
Мой чек-лист после сборки
1. Файл открывается по адресу site.ru/sitemap.xml и не отдаёт ошибок.
2. Количество URL в карте совпадает с количеством индексируемых страниц.
3. Ссылка на карту добавлена в robots.txt.
4. Карта отправлена в Яндекс.Вебмастер и Search Console.
Вместо вывода
Sitemap — пять минут работы и постоянная польза: краулер находит страницы быстрее, а обновления подхватываются раньше.