Как я собираю robots.txt и llms.txt: разбор с генератором
Показываю свой рабочий процесс: как собрать корректные robots.txt и llms.txt для поисковиков и AI-краулеров, какие правила я закладываю и какие ошибки дорого стоят.
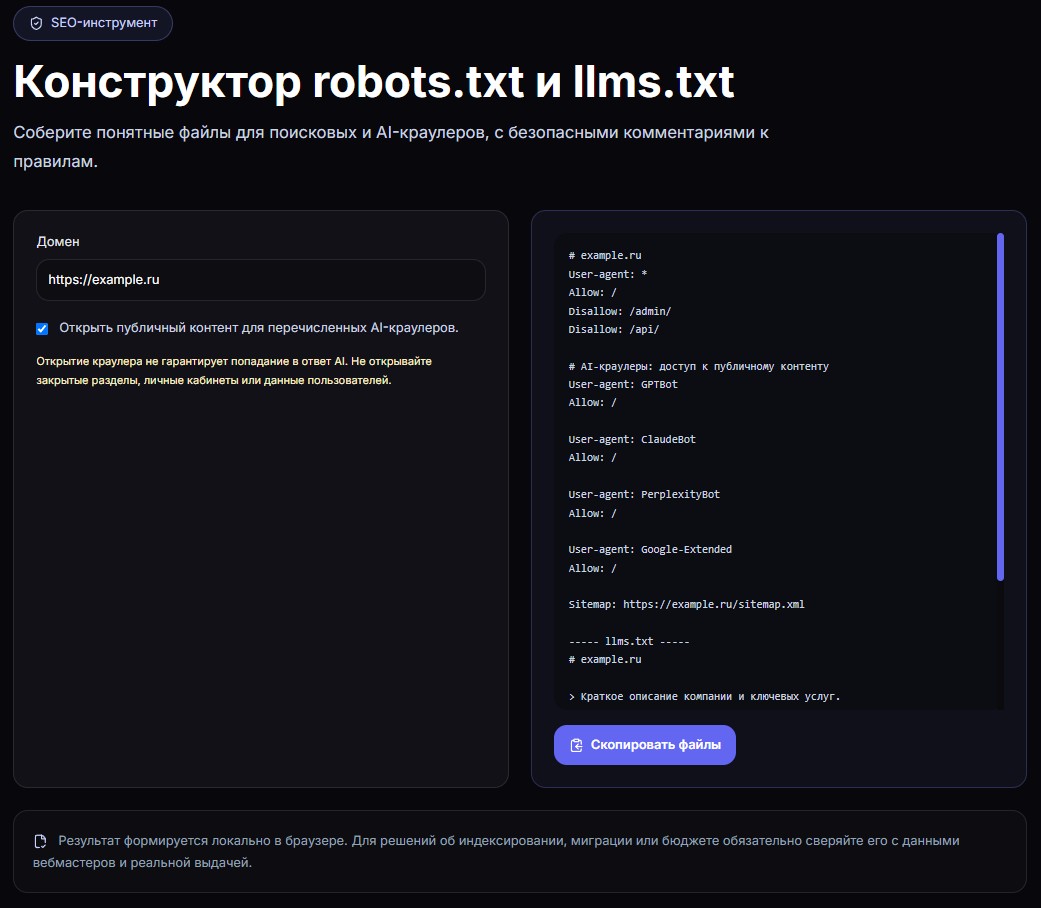
Каждый раз, когда я начинаю работать с новым сайтом, первый технический вопрос — кто и как может его сканировать. От этого зависят и позиции в поиске, и появление бренда в ответах ChatGPT и Perplexity. Два маленьких файла — robots.txt и llms.txt — решают эту задачу, но в них легко ошибиться: одна лишняя строка, и сайт выпадает из индекса.
Я собрал бесплатный генератор robots.txt и llms.txt, чтобы не писать эти файлы руками при каждом запуске. В этой статье показываю свой процесс: что я проверяю до генерации, какие правила закладываю и как проверяю результат.
Открыть генератор robots.txt и llms.txt
Зачем сайту два файла вместо одного
Файлы решают разные задачи и работают в связке:
- robots.txt — правила для поисковых краулеров: Яндекс, Google, Bing. Файл говорит, какие разделы сканировать можно, какие — нельзя, и где лежит sitemap.
- llms.txt — файл для AI-краулеров и языковых моделей: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. В нём в структурированном виде дают краткое описание компании, ключевые услуги и ссылки на главные страницы. Это повышает шанс, что нейросеть корректно процитирует сайт в ответе.
Проще всего так: robots.txt управляет доступом сканеров, llms.txt — самопрезентация сайта для нейросетей.
Что я проверяю до генерации
Прежде чем собирать файлы, я отвечаю на четыре вопроса:
- Какие разделы действительно публичные. Админки, личные кабинеты, API, служебные страницы — в индексе им не место.
- Где лежит sitemap. Обычно это /sitemap.xml, но важно убедиться, что файл актуален.
- Что уже разрешено и запрещено. Если сайт живой, старые правила могли накопиться годами — их стоит пересмотреть.
- Нужен ли сайту трафик из нейросетей. Для контентных проектов и услуг — почти всегда да. Для закрытых корпоративных систем — часто нет.
Как устроен генератор
Всё умещается в один экран. Я указываю домен и отмечаю, открывать ли публичный контент для перечисленных AI-краулеров — генератор сразу собирает оба файла с безопасными комментариями к каждому правилу.
Что получается на выходе
Для обычного сайта генератор собирает примерно такой robots.txt: базовые правила — Allow: / для основного краулера, Disallow: /admin/ и /api/ для служебных разделов, отдельные блоки для AI-краулеров — GPTBot, ClaudeBot, PerplexityBot, Google-Extended — и строка Sitemap со ссылкой на карту сайта.
Рядом формируется llms.txt: заголовок с доменом, краткое описание компании и ключевых услуг — тот контекст, который модели используют при ответе.
Результат собирается локально в браузере: ничего никуда не отправляется. Кнопка «Скопировать файлы» отдаёт готовый текст — остаётся сохранить его в корень сайта.
Мои правила: что открывать и что закрывать
- Для AI открываю всё публичное: статьи, кейсы, страницы услуг. Это новый канал распространения, и он уже приводит клиентов.
- Закрываю служебное: /admin/, /api/, личные кабинеты, внутренние результаты поиска.
- Не открываю то, что не хочу видеть в цитатах: персональные данные, черновики, закрытые прайсы.
- Помню про ограничение: открытый краулер не гарантирует попадание в ответ нейросети. Но закрытый гарантирует, что сайт там не появится.
Частые ошибки в robots.txt, которые я вижу
- Конфликт Allow и Disallow — краулер может понять правила не так, как задумано.
- Закрытые CSS и JS — если запретить папку со стилями и скриптами, поисковик увидит «сломанную» страницу и понизит её.
- Нет строки Sitemap — краулер тратит больше времени на обход, часть страниц находит позже.
- Одно правило на всех — часто нужно разное поведение для разных краулеров.
- robots.txt без llms.txt — в 2026 году это потерянный канал: сайт просто не попадает в базу знаний моделей.
Что делать после генерации
1. Сохранить robots.txt в корень сайта — он должен открываться по адресу site.ru/robots.txt.
2. llms.txt положить рядом — site.ru/llms.txt.
3. Проверить в Яндекс.Вебмастере и Google Search Console, что правила прочитались корректно.
4. Через одну-две недели посмотреть логи сервера: приходят ли AI-краулеры и какие страницы они забирают.
Вместо вывода
Robots.txt и llms.txt — два маленьких файла с большим эффектом: они определяют, увидят ли сайт в поиске и в ответах нейросетей. Соберите их корректно один раз — и не возвращайтесь к этой головной боли.